来源: Anthropic,Scaling Managed Agents: Decoupling the brain from the hands(本地保存的网页标题为 Scaling Managed Agents with stable interfaces)。
原文作者: Lance Martin、Gabe Cemaj、Michael Cohen。原文发布: 2026 年 4 月 8 日。
收藏说明: 本文根据个人保存的本地网页完整翻译,保留正文顺序、案例、链接和原图;正文中的“我们”指原作者。文末“收藏总结”为另行整理,不属于原文。
按照我们的文档,即可开始使用 Claude Managed Agents。
如何构建高效的 Agent,以及如何为长时间运行的任务设计运行框架,一直是工程博客持续讨论的话题。这些工作的一个共同点是:运行框架(harness)中包含了对 Claude 无法独立完成哪些事情的假设。不过,这些假设需要经常重新审视,因为随着模型进步,它们可能会过时。
举一个例子,我们在之前的工作中发现,Claude Sonnet 4.5 感觉到上下文即将达到上限时,会过早结束任务。这种行为有时被称为“上下文焦虑”。我们通过在运行框架中加入上下文重置来解决这个问题。但把同一个运行框架用在 Claude Opus 4.5 上时,我们发现这种行为已经消失了。上下文重置反而成了多余的负担。
我们预计运行框架还会继续演进。因此,我们构建了 Managed Agents:这是 Claude Platform 中的一项托管服务,通过一小组接口,代你运行需要长时间执行的 Agent。这些接口的设计目标,是比任何一种具体实现都更长久,包括我们今天正在运行的实现。
构建 Managed Agents,意味着要解决计算领域的一个老问题:如何为“尚未被构想出来的程序”设计系统。几十年前,操作系统通过将硬件虚拟化为进程、文件这样的抽象解决了这个问题。这些抽象足够通用,能够支持当时尚不存在的程序。抽象比硬件存在得更久。read() 命令不关心自己访问的是 20 世纪 70 年代的磁盘组,还是现代 SSD。上层抽象保持稳定,底层实现则可以自由变化。
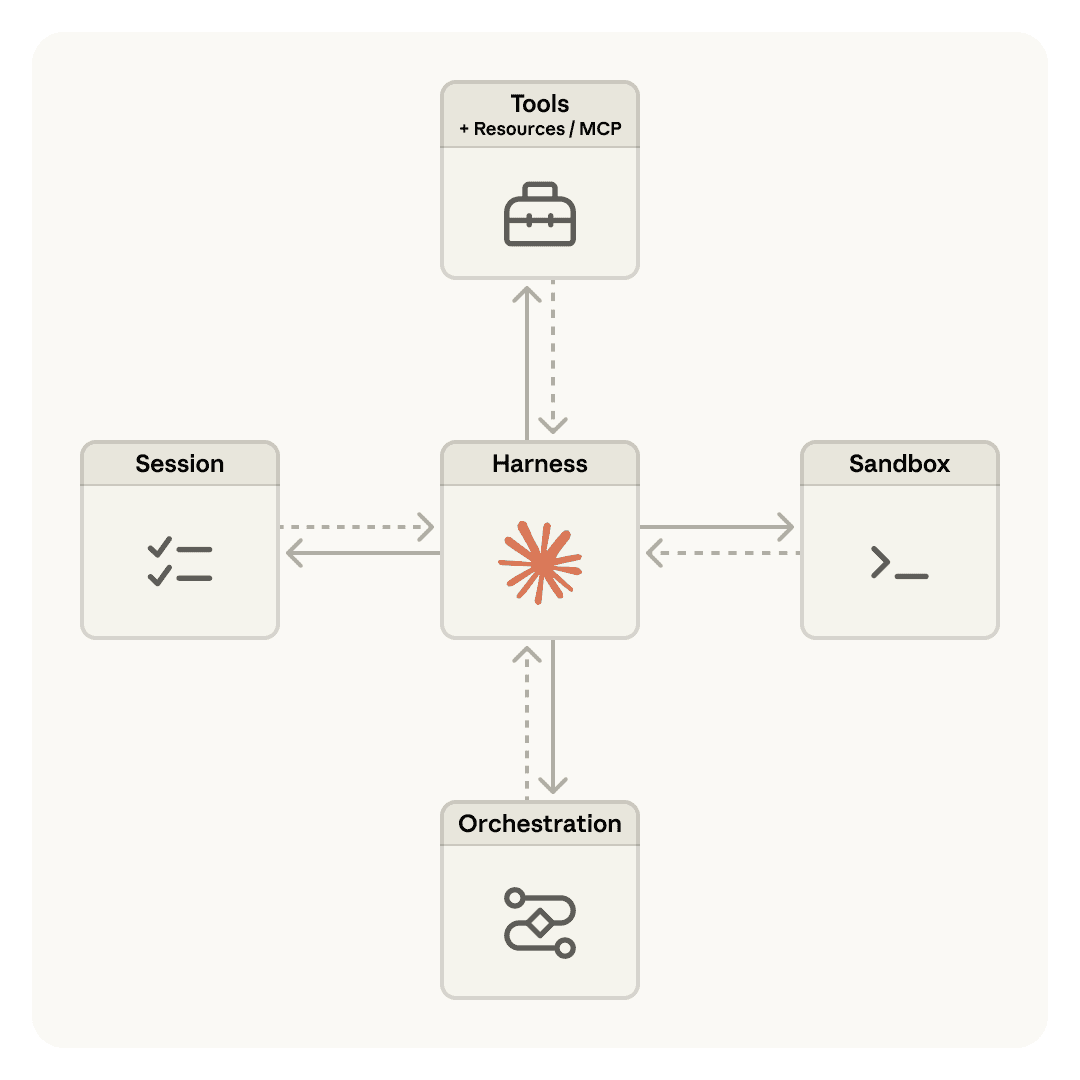
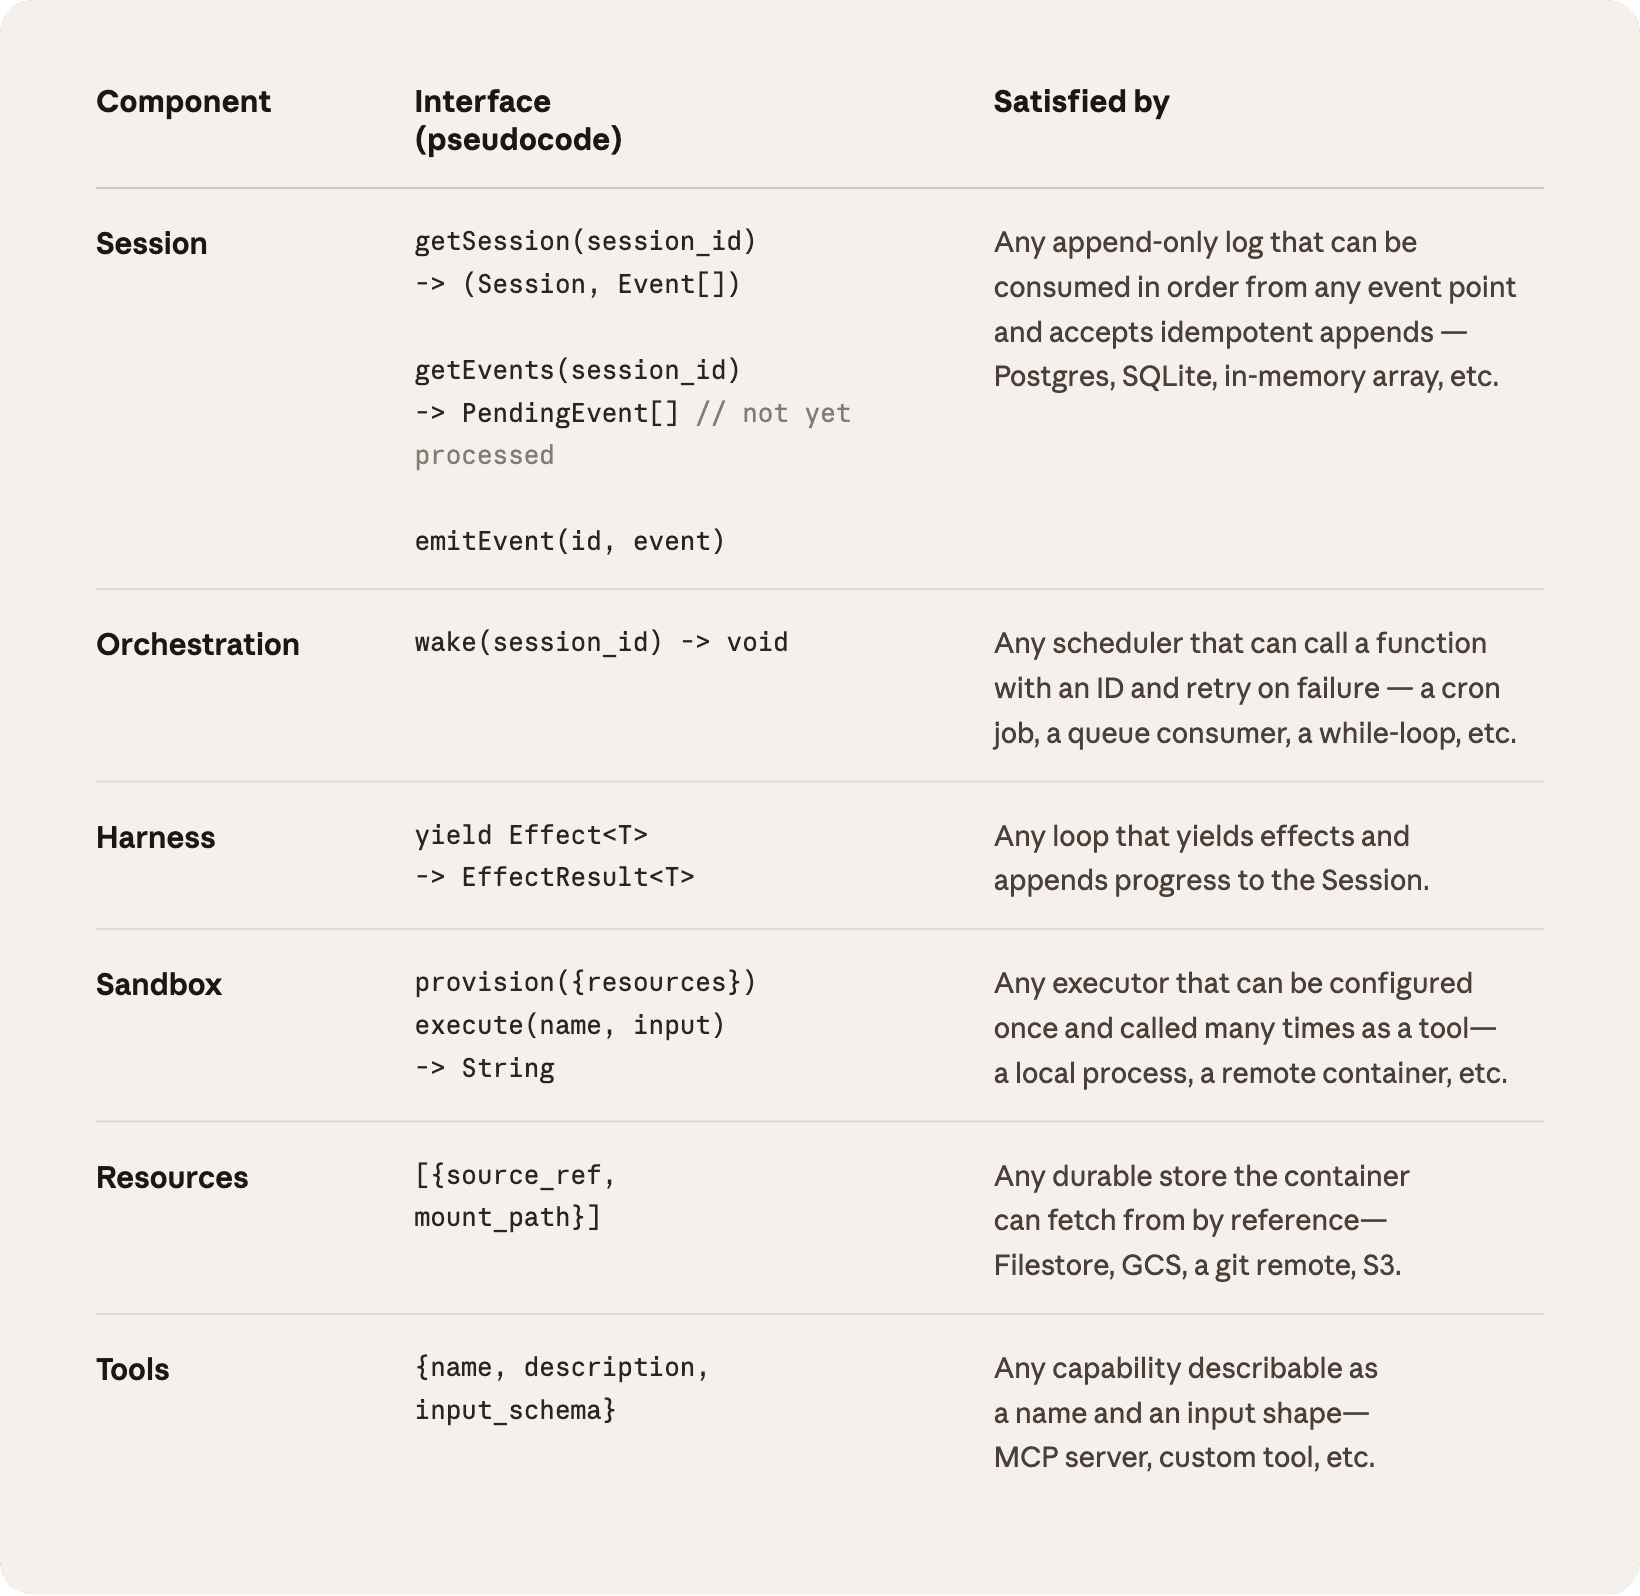
Managed Agents 沿用了同样的模式。我们将 Agent 的组成部分虚拟化:会话(session)是一份只追加、记录所有已发生事项的日志;运行框架(harness)负责循环调用 Claude,并把 Claude 的工具调用路由到对应的基础设施;沙箱(sandbox)则是 Claude 运行代码和编辑文件的执行环境。这样,每个部分的实现都可以被替换,而不影响其他部分。我们对接口的形式有明确主张,而不限定接口背后运行什么。
不要养一只“宠物”
最初,我们把所有 Agent 组件放进同一个容器,也就是说,会话、Agent 运行框架和沙箱共享同一个环境。这种做法有一些好处,比如文件编辑可以直接通过系统调用完成,也不需要设计服务之间的边界。
但将一切耦合到同一个容器后,我们遇到了一个老的基础设施问题:我们养了一只“宠物”。在“宠物与牲畜”的比喻中,宠物是有名字、需要人工精心照料、不能轻易失去的个体,而牲畜则可以相互替换。在我们的场景中,服务器成了这只宠物:容器一旦故障,会话就会丢失;容器一旦没有响应,我们就得把它照料到恢复正常。
照料容器意味着要调试卡住、没有响应的会话。我们唯一能观察内部情况的窗口是 WebSocket 事件流,但它无法告诉我们故障发生在什么地方。因此,运行框架中的缺陷、事件流中的丢包,以及容器离线,看起来都一样。为了弄清楚哪里出了问题,工程师必须进入容器打开 shell,但这个容器往往还存放着用户数据。实际上,这意味着我们缺乏可行的调试手段。
第二个问题是,运行框架假定 Claude 处理的一切都和它一起位于容器中。当客户要求我们将 Claude 连接到他们的虚拟私有云时,他们要么得把自己的网络与我们的网络建立对等连接,要么得在自己的环境里运行我们的运行框架。当我们想要连接不同的基础设施时,运行框架里固化的假设就成了问题。
将大脑与双手解耦
我们最终采用的方案,是将“大脑”(Claude 及其运行框架)与“双手”(执行操作的沙箱和工具),以及“会话”(会话事件日志)分别解耦。每一部分都通过接口暴露能力,对其他部分只做很少的假设,也都可以独立发生故障或被替换。
让运行框架离开容器。 将大脑与双手解耦,意味着运行框架不再位于容器内部。它像调用其他工具一样调用容器:execute(name, input) → string。容器变成了可以替换的“牲畜”。如果容器停止运行,运行框架会将故障捕获为工具调用错误,再传递给 Claude。如果 Claude 决定重试,就可以按照标准方式重新初始化一个新容器:provision({resources})。我们不再需要把发生故障的容器照料到恢复正常。
从运行框架故障中恢复。 运行框架也变成了可以替换的“牲畜”。由于会话日志存放在运行框架之外,运行框架内部没有任何东西必须在崩溃后保留下来。当一个运行框架发生故障时,可以通过 wake(sessionId) 启动一个新的运行框架,用 getSession(id) 取回事件日志,再从最后一个事件继续执行。在 Agent 循环期间,运行框架通过 emitEvent(id, event) 向会话写入内容,留下持久的事件记录。
安全边界。 在耦合设计中,Claude 生成的任何不可信代码,都与凭据运行在同一个容器里。因此,提示词注入只需要说服 Claude 读取自己的环境即可。攻击者一旦拿到这些令牌,就可以创建新的、不受限制的会话,并将工作委派给它们。缩小授权范围是一种显而易见的缓解办法,但这仍然包含一个假设:Claude 拿到权限有限的令牌后,有些事情做不到。而 Claude 正在变得越来越聪明。结构上的修复,是确保 Claude 生成的代码所在的沙箱永远无法触及这些令牌。
我们采用两种模式来保证这一点:授权可以与资源绑定,也可以保存在沙箱之外的凭据保险库中。对于 Git,我们在初始化沙箱时使用每个仓库的访问令牌克隆仓库,并将其接入本地 Git 远程配置。这样,在沙箱内部执行 Git push 和 pull 就能正常工作,而 Agent 自身始终不需要处理令牌。对于自定义工具,我们支持 MCP,并将 OAuth 令牌存放在安全的凭据保险库中。Claude 通过专用代理调用 MCP 工具;代理接收与会话关联的令牌,然后从保险库中获取对应凭据,再调用外部服务。运行框架始终不会获知任何凭据。
会话不等于 Claude 的上下文窗口
长时间运行的任务往往会超出 Claude 上下文窗口的长度,而常规解决方法都涉及对保留什么内容作出不可逆的决定。我们在之前关于上下文工程的工作中探讨过这些技术。例如,压缩(compaction)让 Claude 保存上下文窗口的摘要,记忆工具则让 Claude 将上下文写入文件,从而实现跨会话学习。这些方法还可以与上下文裁剪配合使用,有选择地删除旧工具结果、思考块等 token。
但选择性保留或丢弃上下文的不可逆决定,也可能导致失败。很难预先知道后续轮次会需要哪些 token。如果消息经过压缩步骤转换,运行框架就会从 Claude 的上下文窗口中移除被压缩的消息,只有事先存储了这些消息,才可能将其恢复。此前的研究探索过一种解决办法:将上下文存储为位于上下文窗口之外的对象。例如,上下文可以是 REPL 中的一个对象,大语言模型通过编写代码,对它进行过滤或切片,从而以编程方式访问它。
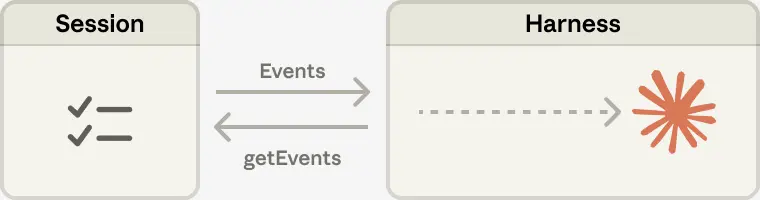
在 Managed Agents 中,会话提供了同样的好处:它充当位于 Claude 上下文窗口之外的上下文对象。不过,上下文并不存储在沙箱或 REPL 内部,而是持久保存在会话日志中。getEvents() 接口让大脑可以按照事件流中的位置选取片段,查询上下文。这个接口可以灵活使用:大脑既可以从上次停止阅读的位置接着读,也可以回退到某个时刻之前的几个事件,了解事情发生前的经过,还可以在执行某个操作之前重新阅读上下文。
取回的任何事件,都可以在传入 Claude 的上下文窗口之前,由运行框架进行转换。转换方式可以是运行框架所实现的任何策略,包括通过组织上下文来获得较高的提示词缓存命中率,以及其他上下文工程手段。我们将会话中可恢复的上下文存储,与运行框架中可自由实现的上下文管理分离,是因为我们无法预测未来的模型具体需要什么样的上下文工程。接口把上下文管理交给运行框架,只保证会话能够持久保存,并且可供查询。
多个大脑,多双手
多个大脑。 将大脑与双手解耦,解决了客户最早提出的一项抱怨。当团队希望 Claude 操作他们自己 VPC 中的资源时,唯一的办法是将他们的网络与我们的网络建立对等连接,因为承载运行框架的容器假定所有资源都在它旁边。运行框架离开容器后,这一假设也随之消失了。同一个改动还带来了性能收益。最初,我们把大脑放在容器里,这意味着有多少个大脑,就需要多少个容器。对每个大脑来说,容器配置完成之前都无法开始推理;每个会话都必须先付出完整的容器初始化成本。每个会话,即使最终完全不会使用沙箱,也得克隆仓库、启动进程,并从我们的服务器拉取待处理事件。
这段等待体现在首 token 时间(time-to-first-token,TTFT)上。它衡量的是从会话接受工作,到产生第一个响应 token 之间要等待多久。TTFT 是用户感受最直接的延迟。
将大脑与双手解耦后,只有在确有需要时,大脑才会通过工具调用(execute(name, input) → string)配置容器。因此,不需要立即使用容器的会话就不用等待容器准备好。编排层从会话日志中拉取待处理事件后,推理便可以开始。采用这种架构后,我们的 p50 TTFT 降低了约 60%,p95 降低了超过 90%。扩展到多个大脑,只意味着启动多个无状态的运行框架,并在需要时将它们连接到双手。
多双手。 我们也希望每个大脑能够连接多双手。在实际使用中,这意味着 Claude 必须推理多个执行环境的情况,并决定把工作发送到哪里。这比在单个 shell 中操作需要更强的认知能力。最初,我们把大脑放在单个容器里,是因为早期模型还不具备这种能力。随着智能水平提高,单个容器反而成了限制:一旦这个容器故障,大脑所连接的每一只手的状态都会丢失。
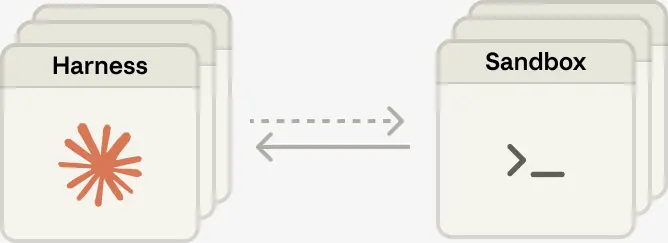
将大脑与双手解耦后,每一只手都变成了一个工具:execute(name, input) → string,输入名称和参数,返回一个字符串。这个接口支持任何自定义工具、任何 MCP 服务器,以及我们自己的工具。运行框架并不知道沙箱究竟是容器、手机,还是宝可梦模拟器。由于任何一只手都不与任何一个大脑耦合,大脑之间还可以将手转交给彼此。
结论
我们面对的是一个老问题:如何为“尚未被构想出来的程序”设计系统。操作系统之所以能存在几十年,是因为它们将硬件虚拟化为足够通用的抽象,从而支持那些当时还不存在的程序。通过 Managed Agents,我们希望设计一个系统,能够容纳未来围绕 Claude 出现的运行框架、沙箱或其他组件。
Managed Agents 是遵循同样思路的元运行框架(meta-harness),并不预先限定 Claude 未来需要哪一种具体的运行框架。它提供的是通用接口,让多种不同的运行框架都能接入。例如,Claude Code 是一个优秀的运行框架,我们将它广泛用于各种任务。我们也已经展示,面向特定任务的 Agent 运行框架,在狭窄领域中表现出色。Managed Agents 能够容纳其中任何一种,随着时间推移适配 Claude 的智能水平。
元运行框架设计意味着,我们对 Claude 周边的接口有明确主张:我们预计 Claude 需要操纵状态的能力,也就是会话;需要执行计算的能力,也就是沙箱。我们也预计 Claude 需要扩展到多个大脑和多双手。我们设计这些接口,是为了让它们能够在长时间运行过程中保持可靠和安全。但我们并不预先假定 Claude 需要多少个大脑、多少双手,也不假定它们位于何处。
作者与致谢
致谢
本文由 Lance Martin、Gabe Cemaj 和 Michael Cohen 撰写。感谢 N.T.A. 和 Jeremy Fox 围绕这些话题展开的有益交流。特别感谢 Agents API 团队和 Jake Eaton 作出的贡献。
收藏总结(另行整理,非原文)
这篇文章讨论的是 Agent 平台如何在模型和运行框架持续变化的情况下,仍然保持可演进的架构。作者将平台拆成三个有独立边界的部分:会话保留持久事件,运行框架负责模型循环与上下文组织,沙箱和工具负责实际执行。稳定的接口让每个部分都可以单独替换、恢复和扩展。
这里有两个紧密相关的设计结果。一个是故障恢复:执行容器和运行框架都变成可以重新创建的组件,会话历史保存在外部。另一个是安全隔离:模型生成的代码与敏感凭据之间形成结构上的边界,外部服务访问由资源集成或代理处理,避免将安全完全建立在模型遵守提示词的基础上。
上下文管理也遵循同样的分工。完整会话日志作为可恢复的历史保存在窗口之外;摘要、裁剪、缓存布局和按需读取由运行框架负责。这样,上下文窗口中的内容经过压缩后,原始历史仍有独立的保存位置,后续可以通过事件接口重新访问。
解耦还改变了资源启动时机:模型推理可以先开始,执行环境在需要时再准备。原文报告的 p50 TTFT 降低约 60%、p95 降低超过 90%,是作者在其系统中得到的结果。支撑这些收益的共同设计,是把持久状态、推理循环和执行资源的生命周期分别管理,再通过少量稳定接口把它们连接起来。